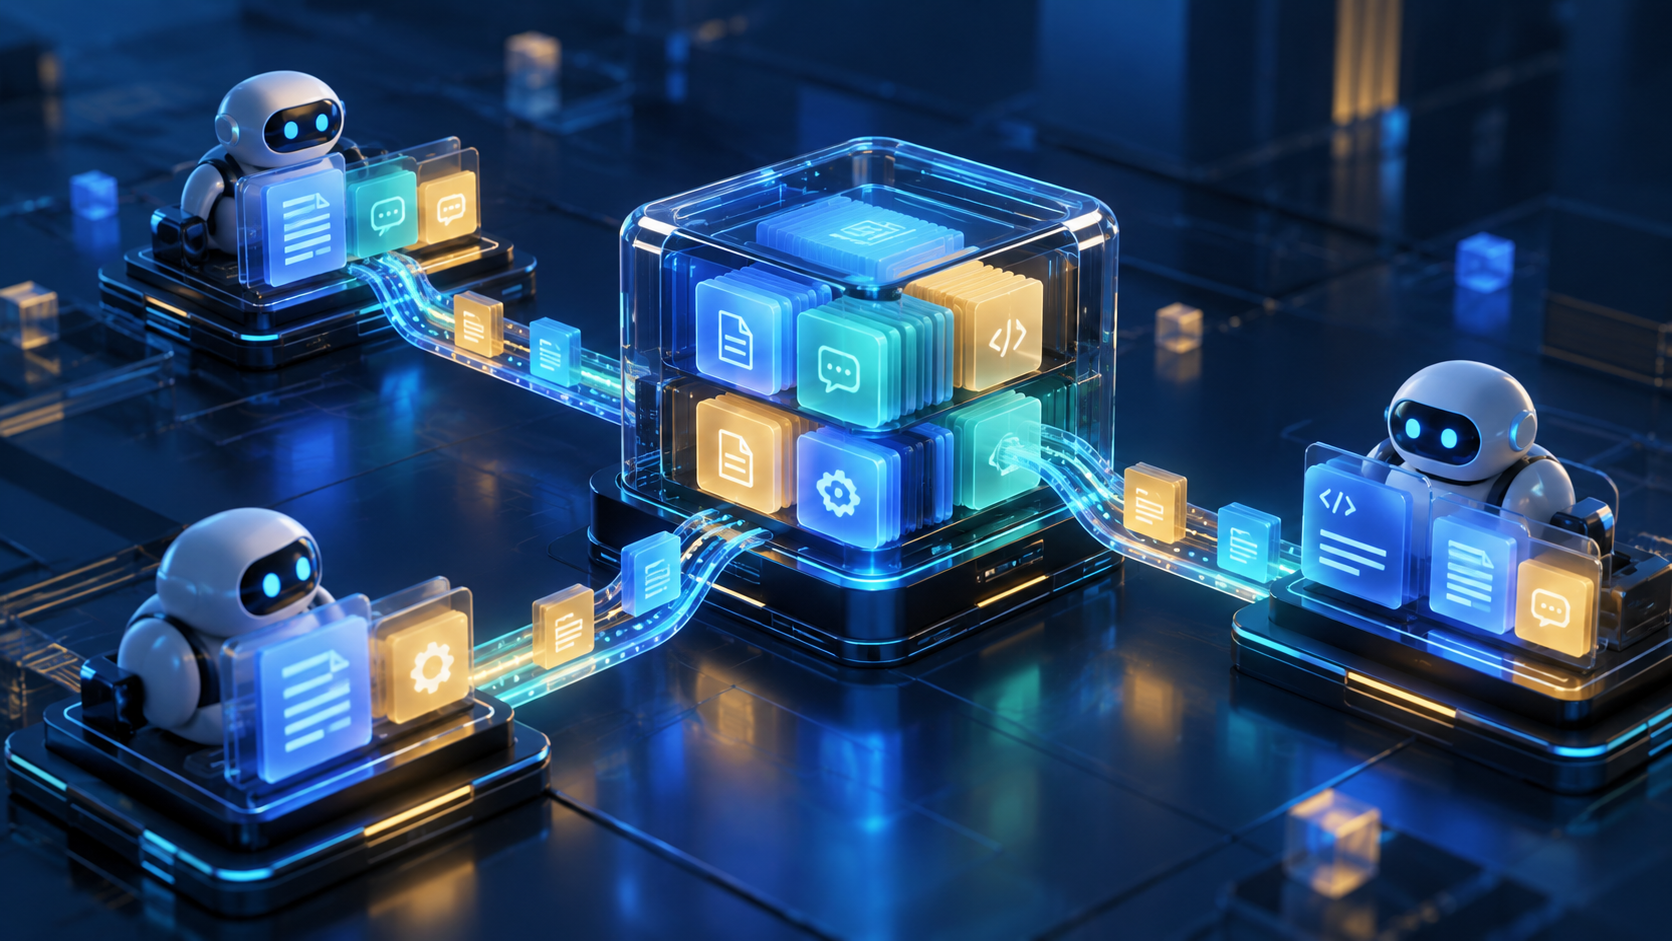
Quando un agente AI lavora per molti passaggi, gran parte di ciò che invia al modello non cambia: istruzioni, regole aziendali, definizioni degli strumenti, esempi e documentazione. Ricalcolare ogni volta quel contesto significa spendere di più e attendere più a lungo. Il nuovo sistema di prompt caching di GPT-6, annunciato da OpenAI il 22 settembre 2026, punta proprio a ridurre questo spreco, con hit rate più alti, strumenti di diagnosi e controlli espliciti sui prefissi da riutilizzare.
Per una PMI non è una novità “da laboratorio”. Può incidere sul costo operativo di assistenti interni, chatbot, automazioni documentali e agenti collegati a CRM, help desk o gestionali. Il punto, però, non è attivare un interruttore e aspettarsi automaticamente grandi risparmi: serve progettare il contesto in modo stabile, misurare i token realmente riutilizzati e verificare che il risultato resti corretto.
Che cos’è il prompt caching, in parole semplici
Una richiesta a un modello contiene spesso una parte stabile e una parte variabile. La parte stabile può includere il ruolo dell’assistente, le policy, le specifiche delle funzioni disponibili e un insieme di esempi. La parte variabile è invece la domanda del cliente, un documento appena caricato o il risultato di uno strumento.
Il prompt caching memorizza il lavoro già svolto dal modello su un prefisso condiviso. Se una richiesta successiva inizia con la stessa sequenza, il sistema può riutilizzare il calcolo precedente anziché ripeterlo. OpenAI indica tre benefici: meno elaborazione duplicata, un prezzo ridotto per i token di input letti dalla cache e una minore latenza prima dell’inizio della risposta.
Con GPT-6 il riuso è eleggibile in una finestra di 30 minuti e gli input letti dalla cache possono ricevere uno sconto fino al 90%. “Fino a” è importante: non tutti i token vengono necessariamente riutilizzati e una modifica nelle parti iniziali del prompt può trasformare un potenziale hit in un miss.
Cosa cambia con GPT-6
Il caching è abilitato di default sui modelli supportati, ma la nuova generazione aggiunge più visibilità e controllo. La documentazione distingue due modalità:
- caching implicito: il sistema sceglie automaticamente i punti eleggibili;
- caching esplicito: lo sviluppatore stabilisce dove termina il prefisso stabile da salvare e riutilizzare.
Per GPT-5.6 e modelli successivi, quindi anche per GPT-6, un prefisso deve contenere almeno 1.024 token visibili per essere memorizzabile. La prima scrittura ha un costo superiore all’input ordinario, mentre una lettura dalla cache costa una frazione dell’input non memorizzato. Il vantaggio economico emerge quando lo stesso blocco viene davvero riutilizzato: un contesto scritto una volta e mai più letto non genera il beneficio sperato.
OpenAI ha inoltre introdotto una dashboard per osservare la quota di input servita dalla cache e uno strumento diagnostico che confronta una richiesta con una risposta recente. La diagnosi può evidenziare, per esempio, che sono cambiati il modello, gli strumenti, le impostazioni o la sequenza degli input. Questo sposta il caching da ottimizzazione invisibile a variabile operativa misurabile.
Perché interessa alle PMI
1. Assistenti con regole e documenti ricorrenti
Un assistente commerciale può ricevere a ogni turno lo stesso catalogo, le stesse istruzioni sul tono e le medesime regole di qualificazione dei lead. Un agente per l’assistenza può condividere procedure, limiti di garanzia e definizioni degli strumenti. Se questi blocchi sono lunghi e stabili, rappresentano candidati naturali al caching.
Il risparmio potenziale cresce con il numero di richieste che condividono il medesimo prefisso. Un piccolo team che interroga lo stesso assistente per tutta la giornata può quindi ottenere un beneficio più concreto rispetto a un flusso occasionale composto ogni volta da zero.
2. Agenti che lavorano per più passaggi
Gli agenti mantengono istruzioni, cronologia e definizioni degli strumenti mentre pianificano, cercano informazioni e producono un risultato. È lo scenario in cui il contesto può diventare costoso. La novità si collega bene alle possibilità descritte nell’articolo su GPT-6 Astra e gli agenti AI per le PMI: più autonomia richiede anche una gestione disciplinata del contesto.
OpenAI segnala che, sui modelli GPT-6, è possibile modificare lo sforzo di ragionamento tra le risposte senza rompere la cache, mantenendo stabile la configurazione principale e aggiungendo un aggiornamento. Allo stesso modo, invece di rimuovere e reinserire le definizioni degli strumenti, è preferibile conservarne schema e ordine, limitando di volta in volta quelli utilizzabili.
3. Applicazioni con tempi di risposta sensibili
In un chatbot rivolto ai clienti, anche una riduzione modesta della latenza percepita può migliorare l’esperienza. Il caching non accelera ogni fase e non riduce i token di output, ma evita di rielaborare parte dell’input. Per richieste lunghe e ripetitive, questo può anticipare l’inizio della risposta.
Come progettare un prompt che si riutilizza
La regola principale è semplice: mettere prima ciò che cambia raramente e dopo ciò che cambia spesso. Un ordine ragionevole può essere:
- istruzioni di sistema e policy aziendali;
- definizioni degli strumenti, mantenute nello stesso ordine;
- documentazione o esempi condivisi;
- cronologia della sessione;
- dati dinamici e richiesta corrente.
Se una data, un identificativo casuale o una lista riordinata compare all’inizio del prompt, tutte le parti successive possono perdere l’identità necessaria al riuso. Conviene spostare i valori volatili in fondo e applicare una serializzazione deterministica: stessi campi, stesso ordine e stessa formattazione quando il significato non cambia.
Anche le istruzioni correttive vanno preferibilmente aggiunte verso la fine, anziché riscrivere il blocco iniziale. Questo permette di cambiare il comportamento richiesto preservando il prefisso condiviso. Resta necessario verificare che le nuove istruzioni non creino conflitti o ambiguità.
Un piano di adozione in cinque passi
1. Scegliere un flusso ripetitivo
Partire da un caso con volume sufficiente e contesto stabile: classificazione delle richieste, estrazione dati da documenti omogenei, assistenza interna o preparazione di risposte commerciali. Evitare come primo test un processo raro o soggetto a frequenti cambi di policy.
2. Misurare la situazione iniziale
Registrare, per un periodo rappresentativo, token di input, latenza, costo e tasso di completamento corretto. Senza una baseline non è possibile distinguere un vero miglioramento da una variazione del traffico.
3. Separare contesto stabile e dati dinamici
Riorganizzare il prompt senza cambiare lo scopo del servizio. Le istruzioni condivise devono stare all’inizio; dati del cliente e risultati aggiornati vanno dopo. Se il prefisso supera la soglia minima e viene riutilizzato entro la finestra prevista, diventa eleggibile per la cache.
4. Osservare hit e miss
La metrica più utile è la quota di token di input letta dalla cache, non soltanto il numero di richieste con almeno un hit. La documentazione espone i token memorizzati e quelli scritti; la dashboard aggrega l’andamento, mentre la diagnosi aiuta a capire perché un riuso atteso non è avvenuto.
5. Confrontare costo, velocità e qualità
Un’ottimizzazione è valida solo se le risposte restano corrette. Confrontare un gruppo prima e dopo la modifica, includendo casi normali, errori degli strumenti e richieste anomale. In produzione, definire soglie di allarme per improvvisi cali del tasso di cache e aumenti di costo.
I limiti da non ignorare
Il prompt caching non è una memoria aziendale e non sostituisce un database o un sistema RAG. Riutilizza calcolo su un prefisso identico; non decide quali informazioni siano aggiornate e non corregge dati obsoleti. Un listino cambiato deve essere aggiornato anche se ciò invalida la cache: la correttezza viene prima del risparmio.
Non va neppure confuso con la continuità di una conversazione. La documentazione chiarisce che mantenere una sessione può preservare un prefisso condiviso, ma non garantisce un hit. Il risultato dipende da lunghezza, identità del prefisso, tempi e impostazioni della richiesta.
La cache non elimina inoltre i rischi degli agenti. Permessi minimi, conferme per le azioni sensibili, log e controlli restano indispensabili. Le regole pratiche di sicurezza per gli agenti AI continuano a valere, indipendentemente dal costo dell’inferenza. Quando un agente interagisce con un sito tramite strumenti strutturati, è utile anche conoscere l’approccio descritto in WebMCP e WordPress per siti utilizzabili dagli agenti.
Quali KPI seguire
Per un progetto aziendale sono sufficienti pochi indicatori, purché vengano osservati insieme:
- token totali di input, token scritti in cache e token letti dalla cache;
- tasso di hit calcolato sui token, aggregato per flusso o cliente;
- costo medio per attività completata, non solo per singola chiamata;
- tempo al primo output e durata complessiva del workflow;
- percentuale di risultati corretti e interventi umani necessari.
Una percentuale alta di cache non è un obiettivo in sé. Se per ottenerla si gonfia artificialmente il prompt o si conserva contesto non più pertinente, il sistema può diventare più caro o meno accurato. La metrica finale resta il costo di un risultato utile e verificato.
Conclusione: efficienza, ma con disciplina
Il prompt caching di GPT-6 rende più controllabile uno dei costi nascosti degli agenti: ripetere continuamente le stesse istruzioni e definizioni. Per le PMI l’opportunità è concreta nei flussi con contesto lungo, stabile e riutilizzato molte volte. Dashboard, diagnostica e breakpoint espliciti aiutano a passare dalle ipotesi alle misure.
Il percorso consigliato è pragmatico: scegliere un workflow, creare una baseline, stabilizzare il prefisso, monitorare hit e miss e verificare qualità e costi. Non serve riprogettare tutto in una volta. Un singolo processo ben misurato può mostrare se l’ottimizzazione merita di essere estesa al resto dell’azienda.
Fonti
- OpenAI – Better prompt caching for GPT-6, 22 settembre 2026.
- OpenAI API – Prompt caching, documentazione tecnica consultata il 25 settembre 2026.
- OpenAI API – Prompt cache diagnostics, documentazione tecnica consultata il 25 settembre 2026.